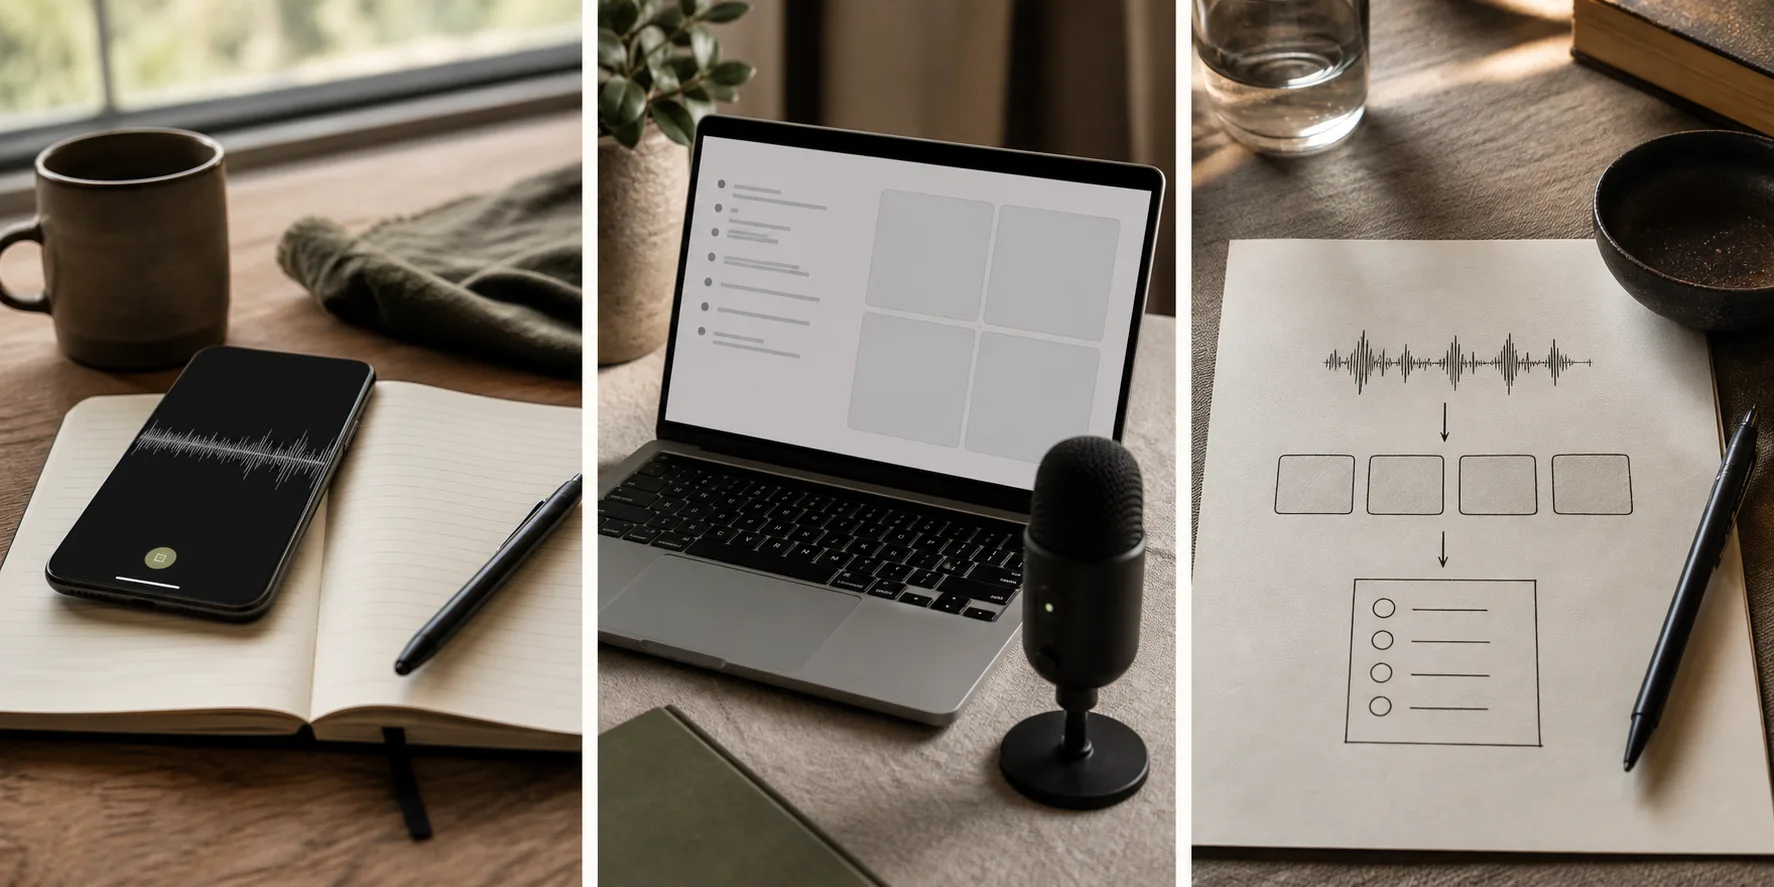
語音保留了更多背景
用講的通常比逐字輸入快,也不必先把完整想法壓縮成幾句 prompt。不論坐在電腦前、走路或使用手機,我都能先把當下的背景、擔心與判斷說出來。
語音不是直接交給 Agent
Typeless 先處理口語裡的停頓、重複和改口。文字接著由大語言模型整理成目標、背景、限制與完成條件;確認內容沒有偏離我的意思後,才交給 Agent 執行。
- 目標:這次真正想完成什麼。
- 背景:為什麼要做,已有什麼條件。
- 限制:不能碰哪些資料、時間或技術邊界。
- 完成條件:怎樣才算真的做好。
以前我是在寫 Prompt,現在更像是在 Brief Agent。
人的責任沒有消失
我負責把意圖說完整、確認整理後的 context,並 review 最後結果;Agent 負責搜尋、執行與整理。語音減少的是輸入摩擦,不是人的判斷責任。